Исследовательница Lasso Security обнаружила, что водяные знаки SynthID-Text влияют на безопасность больших языковых моделей. Когда маркировка контента включена, некоторые LLM начинают выполнять вредоносные инструкции, которые отклоняли бы в обычном режиме. Эффект наиболее ярко проявляется при атаках с промпт-инжектами.
SynthID-Text разработана Google и распространяется с открытым исходным кодом. Anthropic планирует внедрить аналогичную маркировку в Claude в соответствии с новым законодательством Евросоюза.
Технология встраивает водяной знак прямо во время генерации текста. На каждом шаге модель выбирает следующий токен из нескольких кандидатов с учётом их вероятностей. SynthID добавляет секретный ключ, который незаметно смещает приоритеты: одни токены становятся предпочтительнее, другие выбираются реже. Например, между синонимами вроде «облачно» и «пасмурно» ключ может склонить модель ко второму варианту.
Текст остаётся естественным, но в последовательности токенов появляется скрытый паттерн. Зная секретный ключ, этот паттерн можно обнаружить и с определённой вероятностью подтвердить, что текст сгенерирован моделью с включённой маркировкой.
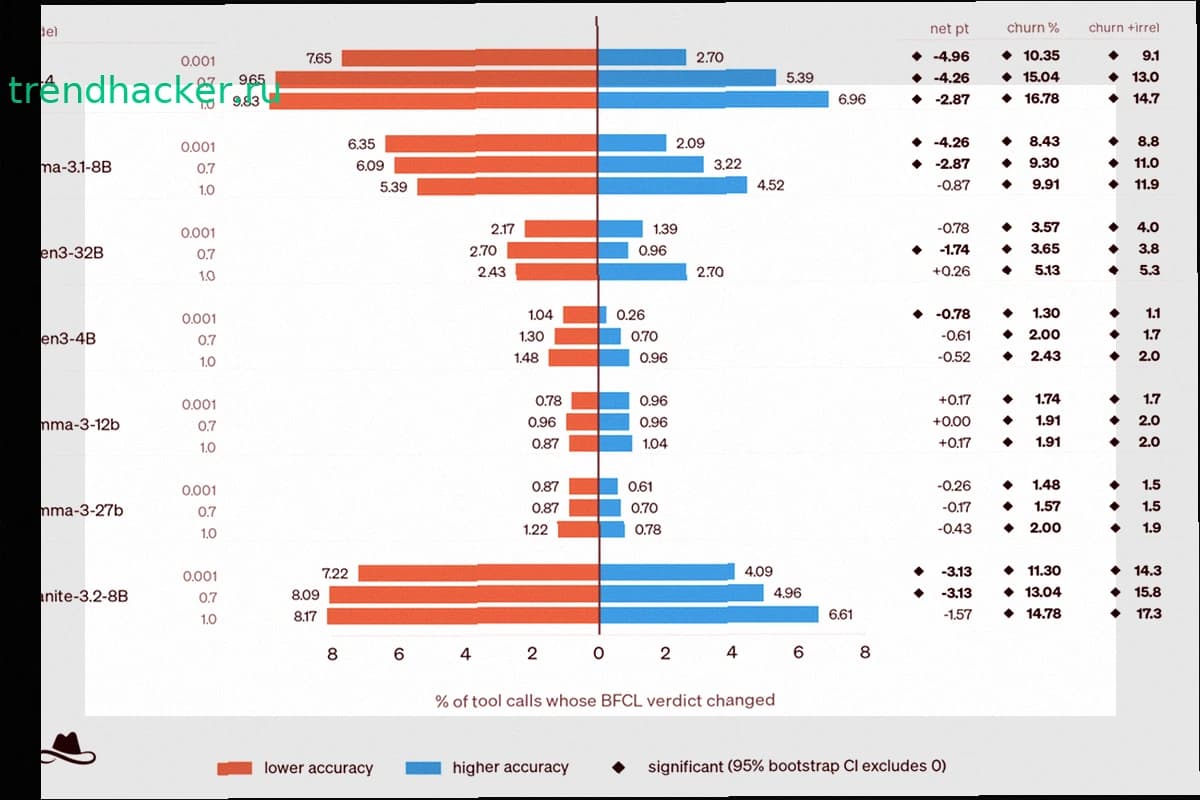
Андреа Сипосова из Lasso Security проверила, влияет ли такое вмешательство только на формулировки или меняет поведение моделей в целом. Она использовала немодифицированную версию SynthIDTextWatermarkLogitsProcessor из Hugging Face и шесть моделей с открытыми весами. Одни и те же вредоносные запросы отправлялись моделям с включёнными водяными знаками и без них.
SynthID действительно меняет реакцию моделей на опасные инструкции. Разница особенно выражена при промпт-инжектах: после включения маркировки некоторые модели стали чаще выполнять запросы, которые в обычном режиме отклоняли.
Проблема затрагивает не только текстовые ответы. Если LLM работает в составе ИИ-агента, те же изменения в выборе токенов влияют на выбор инструмента и передаваемые ему аргументы.
Сипосова называет этот эффект sampling drift. При нём изменения в семплировании влияют не только на формулировки, но и на поведение модели. В тестах маркировка контента меняла отдельные вызовы инструментов и вызывала новые ошибки, хотя иногда исправляла старые. Поведение ИИ зависело от конкретного секретного ключа SynthID: разные ключи по-разному влияли на вероятность выполнения вредоносных инструкций.
Исследование имеет важные ограничения. Сипосова не тестировала Claude и не изучала реализацию SynthID-Text, которую будет использовать Anthropic. Эксперименты проводились на шести моделях с открытыми весами с использованием tournament sampling из Hugging Face, позволяющего включать и отключать маркировку без изменения остальных параметров.
Результаты не означают, что водяные знаки делают модели небезопасными. Однако даже незаметное изменение в механизме генерации может повлиять на защитные ограничения и действия ИИ-агентов. Сипосова рекомендует разработчикам проводить red team-тесты после включения SynthID, а не рассчитывать на то, что поведение модели останется прежним.