Разработчик загружает код в три часа ночи — это аномалия или норма? Ответ зависит от контекста, и именно он определяет, будет ли срабатывание считаться инцидентом. Система видит действие, но без контекста не может оценить риск. В этом материале разберем, как настраивать фильтры на основе реальных бизнес-процессов, а не просто ужесточая правила.
Природа ложных срабатываний
Ложные срабатывания — не ошибка, а симптом недостатка данных. Когда шлюзовое решение видит подключение на нестандартный адрес, но нет информации о том, что делает сотрудник на конечной точке, система не может верифицировать действие. Она отмечает его как подозрительное, и аналитик получает тысячи срабатываний, требующих ручной проверки.
Пример: сотрудник уехал в командировку, часовой пояс сдвинулся на четыре часа. Система видит вход в пять утра и срабатывает по политике рабочего графика. Нужные данные о командировке в системе отсутствуют.
Еще один пример: запрос информации по клиентам сам по себе может быть частью должностных обязанностей. Но если добавить контекст — сотрудник в процессе увольнения, — этот же запрос становится инцидентом высокого риска.
Три уровня фильтрации
Первый уровень: процесс и регламент. Когда допустимые сценарии описаны заранее, система ранжирует события по степени риска вместо жесткой блокировки. Легитимные действия получают низкий приоритет, но сохраняются как контекст для оценки других активностей.
Второй уровень: идентификация и доступы. Подключаются данные из смежных систем: логи VPN, второго фактора, шлюзов, журналы доступа. Подключение к нехарактерным ресурсам — сигнал. Чтобы понять, что именно сотрудник делал после подключения, нужны данные с конечной точки: какие файлы открывались, куда отправлялись, с кем велась переписка.
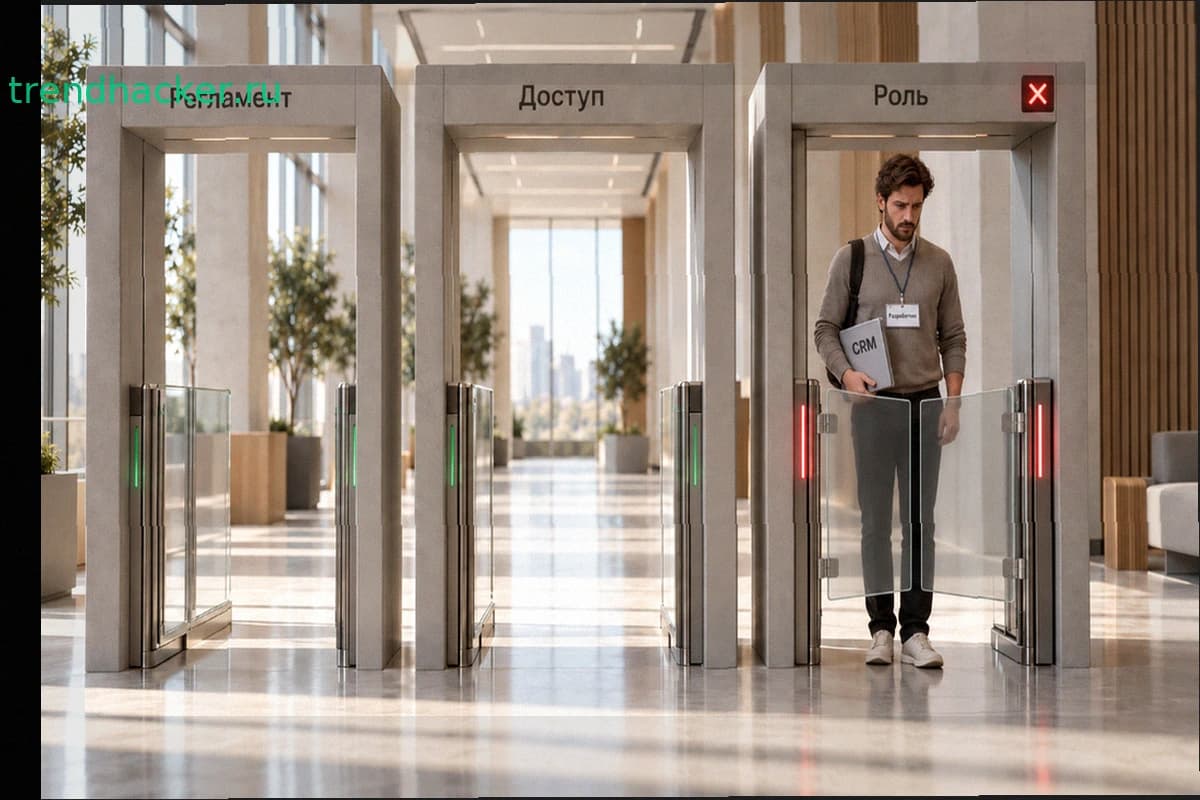
Третий уровень: действия и должностные обязанности. Если разработчик работает с кодом — это норма. Если разработчик идет в CRM и выгружает клиентскую базу — это инцидент. Массовые обращения к данным вне должностных обязанностей требуют немедленной реакции.
Система должна ранжировать события по степени риска на основе профиля сотрудника и его обычной активности. Не всякая аномалия — атака, но сочетание нехарактерного времени, необычных доступов и выхода за пределы должностных обязанностей — это маркер, требующий немедленной реакции.
Поведенческий анализ: возможности и ограничения
Поведенческий анализ (UEBA) пытается выявить аномалии без ручного прописывания правил. Звучит как решение, но практика сложнее.
Классический статистический UEBA ищет отклонения от единой нормы, что создает проблемы: менеджер и разработчик работают по-разному, внешние факторы вроде сезонности или новых проектов меняют активность, но не являются аномалией. Если применять поиск аномалий ко всем активностям подряд, ложные срабатывания гарантированы.
Современные системы группируют сотрудников по схожим задачам, но это требует времени на настройку. Ошибки в конфигурации или неверно выбранные группы сравнения ведут к лавине срабатываний.
Подходы с машинным обучением и нейросетями имеют риски: качество обучения зависит от данных, требуется постоянная обратная связь от аналитиков, возникает вопрос доверия к автоматическим выводам.
Система не начинает работать идеально с первого дня. Она выдает тысячи аномалий, аналитик подтверждает, что большинство — ложные, и только после нескольких циклов обратной связи начинает давать адекватные результаты. На результаты можно полагаться как на поток срабатываний, который сокращается по мере обучения, но перепроверка необходима. Главное условие: любые настройки должны опираться на реальные процессы компании.
Передавать логи, персональные данные, пароли и адреса инфраструктуры во внешний сервис значит выносить их за периметр. Даже если сервис обещает безопасность, это чужая инфраструктура, которую вы не контролируете.
UEBA — инструмент, который подсвечивает паттерны и аномалии, но не заменяет человека. Принимать решение должен специалист, знающий контекст и процессы компании. Без этого поведенческая аналитика превращается в генератор дополнительного шума.
Метрики оценки работы
Гнаться за количеством инцидентов — самый вредный путь. Чем хуже настроена система, тем больше событий она генерирует. Эффективность — это качество событий и цена обработки.
Снижение ложных срабатываний. Если система выдает 10 000 событий в день, а 9 900 — ложные, она не работает. Если число инцидентов снизилось до 100, из них ложных 30 — с такой нагрузкой уже можно работать. Чем ниже доля ложных — тем лучше система учитывает реальные процессы.
Скорость обнаружения и устранения (MTTD / MTTR). Этот показатель отражает зрелость процессов расследования, но система тоже влияет на скорость. Если инцидент выявляется через 20 часов, это провал.
Время администрирования. Сколько часов в день уходит на проверку стабильности? Если два часа ежедневно — это слепое пятно, в момент обслуживания может произойти инцидент, который система не зафиксирует. Стабильность работы не менее важна, чем точность обнаружения.
Защита для малого бизнеса
В малых компаниях нет SOC и выделенных ресурсов. Один-два специалиста закрывают мониторинг, настройку и реагирование. Универсальных рецептов нет, но есть общий принцип: идти от последствий.
Шаг первый: сбор данных без анализа. Начните собирать логи со всех сервисов, с которыми работают сотрудники. Не пытайтесь сразу выявлять инциденты — накапливайте информацию. В случае чего будет архив, к которому можно вернуться. Это не требует больших ресурсов, но дает базу для следующих шагов.
Шаг второй: определить наиболее высокие риски. Спросите у руководства: «Из-за какого инцидента компания перестанет существовать?» и «За что могут привлечь к ответственности лично?» Ответы — приоритет номер один. Штрафы важны, но уголовные последствия и остановка бизнеса критичны в первую очередь.
Шаг третий: настроить политики под эти риски. Используйте архив данных, чтобы выявить, как могут произойти критичные события, и настройте систему на их обнаружение. Постепенно вы закрываете самые опасные сценарии, не утопая в общем потоке.
Шаг четвертый: коммуникация с бизнесом. В малых компаниях процессы часто не задокументированы. Менеджеры и HR знают, кто чем занимается и где могут быть риски. Вместе вы настроите защиту, которая не сломает работающие процессы, но прикроет уязвимые места.
В любой системе безопасности заложен компромисс: чем шире захват, тем больше шума, чем уже фокус — тем выше риск пропустить атаку. Баланс можно найти только через понимание контекста. Не через количество агентов или лицензий, а через ответы на простые вопросы: что мы защищаем, от кого и почему это критично.
Технологии эволюционируют, но проблема остается: системы не умеют различать дедлайн и кражу данных, командировку и аномалию. Это умеют делать люди — если знают, куда смотреть. Чем глубже аналитик погружен в реальные процессы компании, тем точнее он отличит угрозу от ложной тревоги.