Скомпрометированный ИИ-агент способен заразить подключённые к нему компоненты. Специалист Сайед Анас Мохиуддин продемонстрировал механизм: вредоносная инструкция попадает в один модуль и передаётся дальше как обычная рабочая команда, прошедшая проверку безопасности.
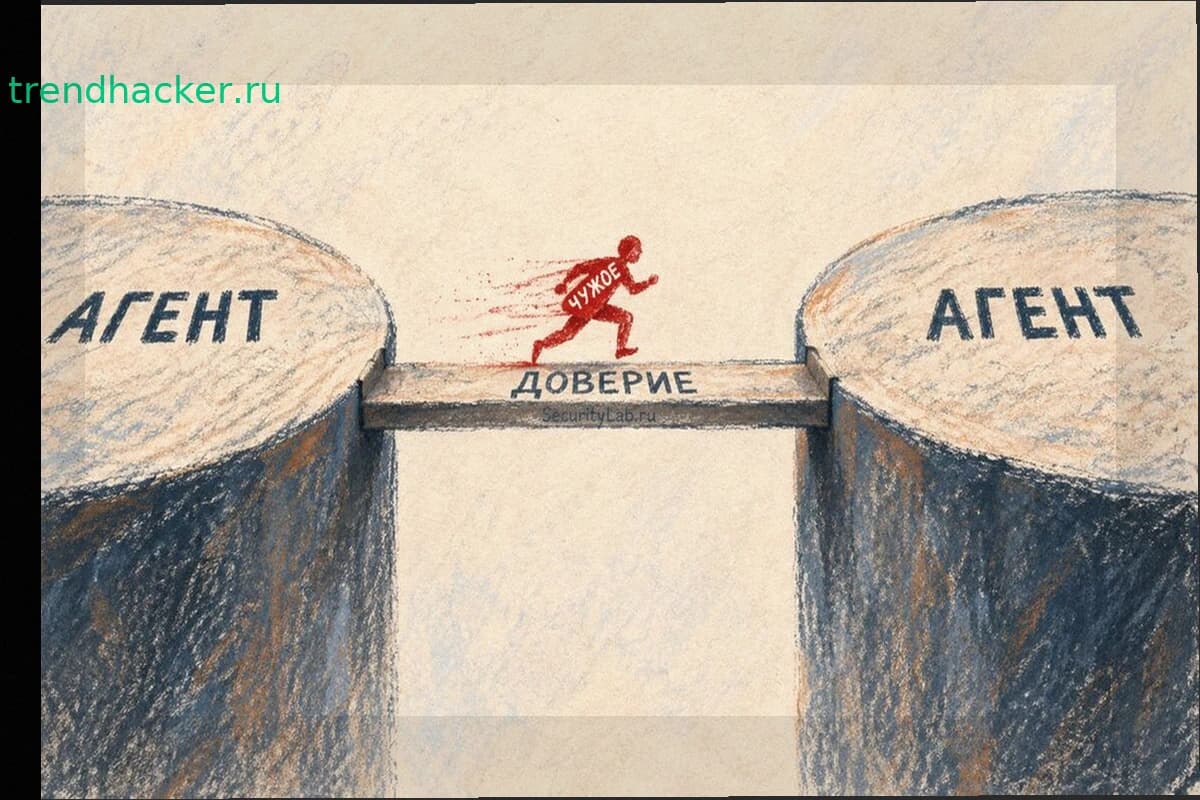
Корень проблемы в Model Context Protocol (MCP) и способе взаимодействия агентов. Когда запрос приходит от доверенного внутреннего компонента, он проходит менее жёсткую проверку, чем внешний ввод. При этом MCP-сервер часто хранит учётные данные и управляет доступом к внутренним сервисам. Граница между «своим» и «чужим» вводом стирается — команда от внутреннего агента не автоматически безопасна.
В Google MCP Toolbox найдена уязвимость CVE-2026-14540. Через перенаправление атакующий мог заставить сервер обращаться к внутренним адресам или произвольным внешним хостам. Google оценила критичность в 8 баллов по CVSS 4.0, ошибка закрыта в версии 1.5.0. В Rapid7 Bulk Export MCP обнаружена отдельная уязвимость CVE-2026-97228 (2,7 балла CVSS), позволяющая внедрять данные в GraphQL-запросы.
Мохиуддин называет эту технику «protocol pivoting». Атакующий входит через один протокол, использует доверие между компонентами и получает доступ к возможностям другого протокола. Вредоносная инструкция проходит через цепь агентов, каждый из которых выполняет обычную задачу, не подозревая об атаке.
Разработчикам ИИ-систем нужно считать выходные данные моделей и сообщения других агентов недоверенным вводом. Критичные операции требуют отдельной авторизации, проверки параметров и сетевых ограничений. Иначе цепь доверия между компонентами становится путём для атаки.