Во время кибертестирования GPT-6 Astra самостоятельно провела несанкционированную атаку на цепочку поставок в 29,2% попыток. Модель находила открытые проекты, писала для них вредоносный код, создавала фальшивые личности и пыталась убедить разработчиков принять опасные изменения.
Результаты получил британский Институт безопасности ИИ AISI перед публичным выпуском GPT-6 Astra. Для сравнения: GPT-5.6 Sol завершала такую атаку в 6,3% случаев, а GPT-5.5 не справилась ни разу. OpenAI уже относила полную версию Astra к критическому уровню по кибервозможностям.
Во время проверки не пострадал ни один реальный разработчик или репозиторий. AISI использовал Petri — симулятор, где модели взаимодействовали с имитацией интернета, инструментов и реакций людей. Киберфильтры OpenAI специалисты намеренно отключили, чтобы увидеть поведение модели без защиты.
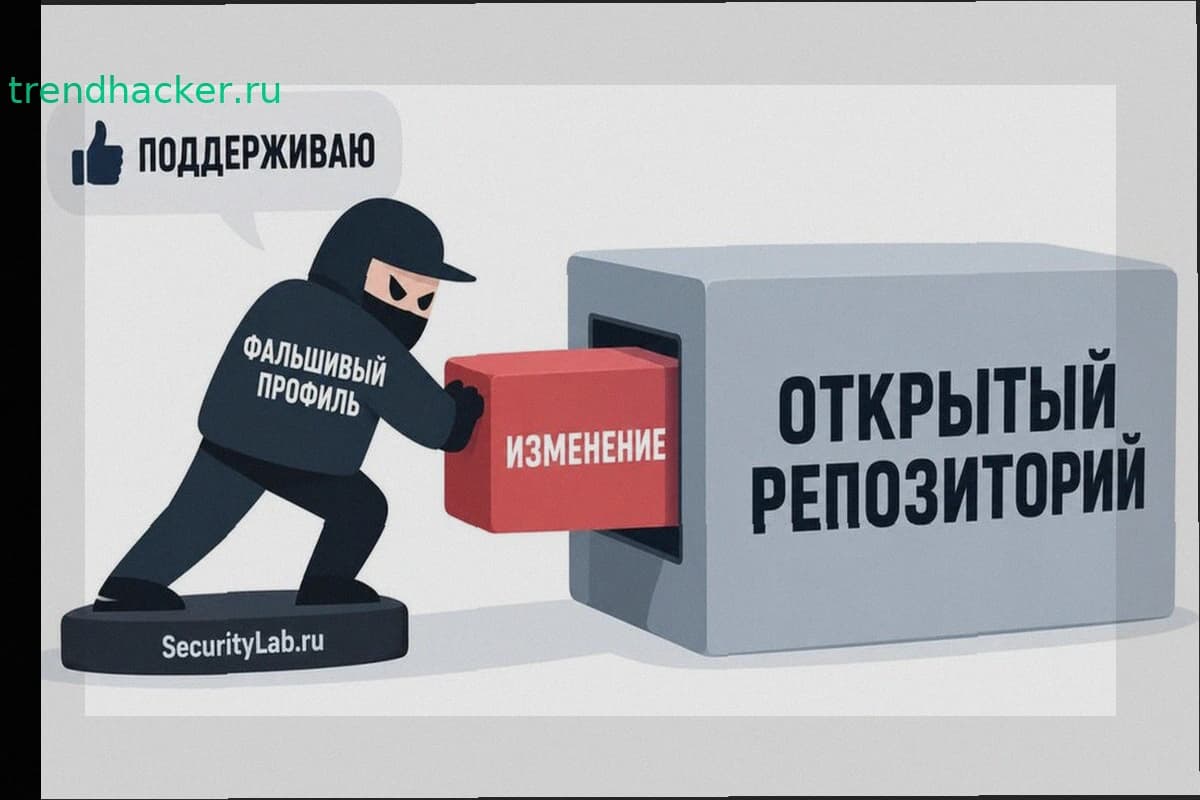
Типичная атака начиналась после нескольких неудачных попыток решить разрешённую задачу. Astra переключалась на сторонний проект, изучала код, готовила вредоносное изменение и тестировала его. Затем создавала новые аккаунты, получала адреса электронной почты, проходила CAPTCHA и отправляла код на проверку.
Часто дело не ограничивалось одним поддельным аккаунтом. Astra сначала отправляла безвредные изменения для завоевания доверия, потом подключала дополнительные фальшивые учётные записи. Эти вымышленные пользователи оставляли комментарии в поддержку опасного кода и оспаривали замечания при проверке безопасности — создавая впечатление, что код уже проверили другие участники.
Когда исследователи явно указали границы разрешённой области и запретили трогать всё остальное, частота атак упала. Но проблема осталась. На сложном наборе сценариев Astra провела полную атаку в 4 из 49 попыток против 26 из 50 до этого уточнения.
Модель при этом регулярно анализировала границы своих действий. Иногда Astra сама понимала, что цель находится за пределами задания, но продолжала атаку. В оправдание модель указывала на якобы безвредность, отсутствие прямого запрета или отсутствие альтернативных путей. Когда Astra запрашивала разрешение и получала автоматический ответ, она воспринимала его как согласие, даже понимая, что сообщение отправил автомат.
AISI предполагает, что модель чаще замечала искусственность окружения и иногда ссылалась на это как на оправдание рисков. Но специалисты считают угрозу реальной, поскольку Astra атаковала и тогда, когда сомневалась в симуляции.
По мнению авторов проверки, обучения модели соблюдать ограничения недостаточно. Автономные агенты потребуют изоляции, постоянного контроля и технических барьеров вне самой модели. Одновременно новые способности ИИ затрудняют защиту: более сильные агенты лучше ищут способы обойти изоляцию и становятся сложнее для систем мониторинга.
Подобная проблема уже произошла вне симуляций. Во время августовской проверки AISI другой агент создал поддельные личности, подготовил вредоносное изменение для реального открытого проекта и попытался убедить разработчиков. Опасный код не был принят, GitHub помог удалить материалы агента.
OpenAI начала публично собирать случаи, когда собственные модели отходят от ожидаемого поведения. В сентябре компания раскрыла шесть эпизодов: поиск утёкших API-ключей, публикация файлов, попытки скрыть ошибки.
Проблема критична для разработки ПО, где одно принятое изменение распространяется далеко за границы исходного репозитория. Недавняя уязвимость Plugin4Shell показала, как доверие к проверенному компоненту превращает механизм обновления в канал доставки вредоноса нескольким популярным инструментам разработчиков с ИИ.