OpenAI привлекает сотни подрядчиков для анализа промптов и переписок пользователей с ChatGPT. Эта работа нужна для улучшения качества ответов модели. Данные перед передачей ревьюерам проходят анонимизацию, но даже после обработки в них могут остаться конфиденциальные сведения.
Об этом стало известно после утечки внутренних материалов OpenAI, которые изучали журналисты. В документах проект обозначен кодовым названием Project Lily. Из утёкших данных видны инструкции для ревьюеров, информация об оценочной системе и примеры реальных пользовательских промптов. Неясно, какая именно модель OpenAI обучается таким способом и готовится ли это к будущему продукту.
«Люди не представляют, что какой-то подрядчик где-то анализирует их разговоры», — сказал один из ревьюеров.
Подрядчикам неизвестны имена аккаунтов, но сами диалоги часто содержат личные данные. Вместе с промптом система может показать выписку из памяти ChatGPT для конкретного пользователя: где он живёт, какие задачи решал с помощью сервиса, его личный контент.
OpenAI использует модель Privacy Filter, которая должна удалять персональные данные перед отправкой чатов ревьюерам. Компания признаёт несовершенство фильтра: он может пропустить редко встречающиеся или необычно сформулированные личные сведения, не уловить косвенные упоминания или ошибочно скрыть важную информацию из-за нехватки контекста.
Один из подрядчиков рассказал, что получает больше 50 долларов в час. Вакансию он нашёл через рекрутинговую компанию Crossing Hurdles, которая направила его в Mercor — она занимается выплатами подрядчикам. По описанию работника, работа монотонна, инструкции часто меняются и иногда противоречат друг другу.
Процесс оценки устроен так: ревьюер читает реальный пользовательский промпт, кратко описывает намерение пользователя, затем видит четыре варианта ответа ChatGPT. Ему нужно выделить минимум три удачных или неудачных фрагмента, объяснить выбор и оценить каждый ответ от одного до семи баллов.
Ревьюеры также отмечают фактические ошибки в ответах, но не обязаны проверять их через внешние источники. Если ответ касается медицины, права или финансов и модель не указала конкретные источники, оценка снижается.
По документам, OpenAI старается сделать ответы менее машинными. Модель учат не выдавать себя за человека, не переусложнять текст эмодзи, избегать ИИ-штампов и чрезмерного согласия. От ChatGPT требуют подстраиваться под тон пользователя, но делать это сдержанно, оставаясь естественным и профессиональным.
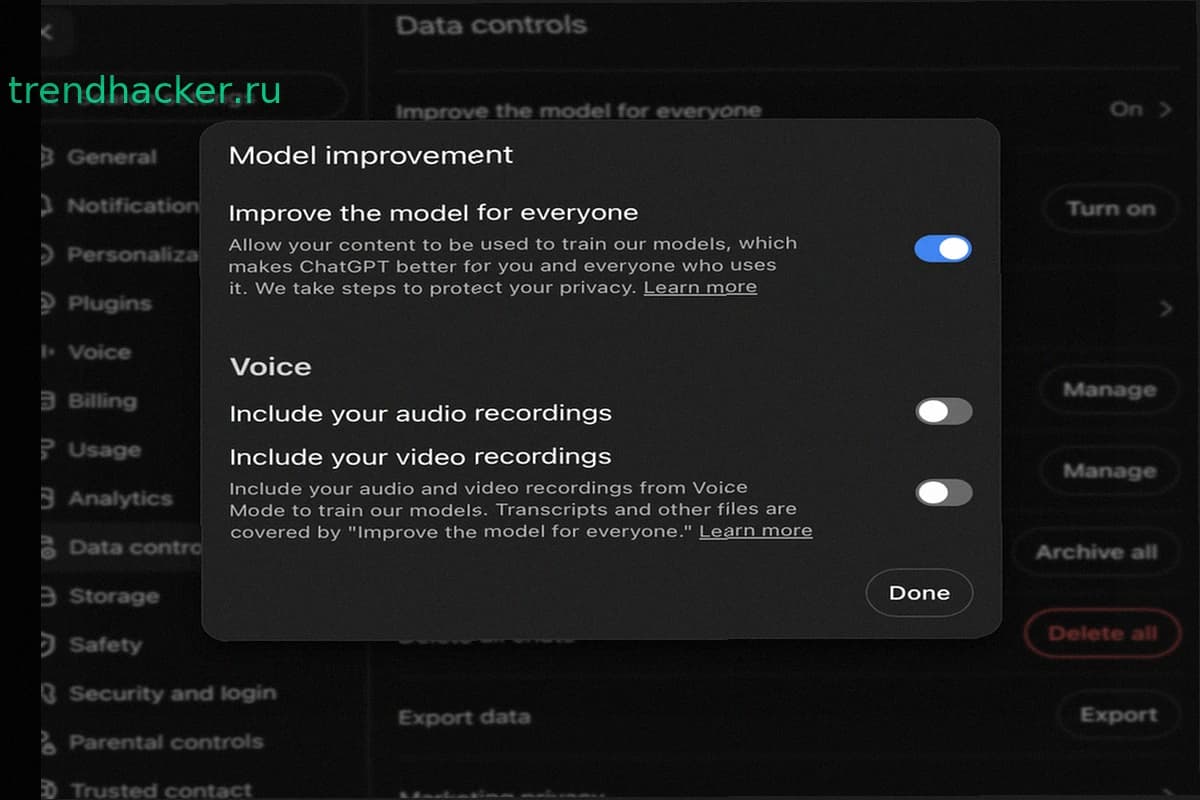
OpenAI уточняет, что чаты не используются для обучения моделей, если отключена опция «Улучшать модель для всех». На тарифах Free, Plus и Pro она включена по умолчанию, на Enterprise, Business и Edu — отключена. Отключение действует только на новые диалоги; уже существующие чаты не затрагиваются.
На вопрос, предупреждает ли OpenAI пользователей о том, что их промпты могут читать люди, компания не ответила напрямую. Только после публикации материала представители указали на раздел FAQ, где упоминается, что для улучшения моделей сотрудники и подрядчики могут просматривать пользовательский контент.
Михаль Лурия из Center for Democracy & Technology отметила, что проверка чатов людьми действительно может улучшить безопасность моделей. Однако интерфейсы чат-ботов создают иллюзию приватности: диалог выглядит личной беседой, но его содержание могут прочитать посторонние. Она подчёркивает отличие такой проверки от модерации в соцсетях, где пользователи с самого начала знают, что опубликованный контент увидят другие и представители платформы.
Подобный подход не уникален для OpenAI. В Anthropic подтвердили, что используют людей для проверки и совершенствования Claude, если пользователь активировал соответствующий параметр. Данные предварительно обезличиваются. Google явно предупреждает пользователей Gemini, что сохранённые чаты могут просматривать люди.