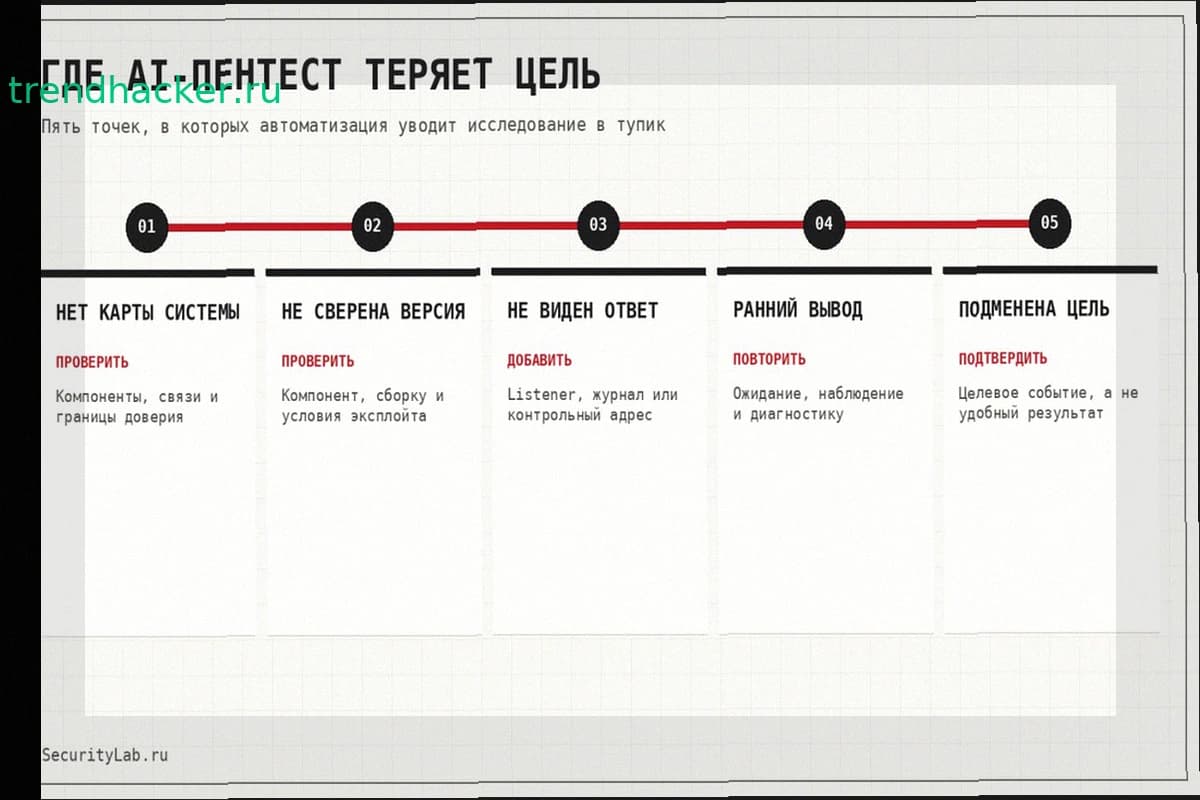
AI-агент может самостоятельно изучить приложение, подобрать нужную технику, запустить инструменты и собрать доказательства уязвимости. Но между «может» и «стабильно делает» стоит целая полоса препятствий.
На учебном веб-приложении проводился практический эксперимент: агенту поставили задачу исследовать систему, найти путь её эксплуатации, выйти из песочницы, повысить привилегии и выполнить контрольное действие. Он справился, но несколько раз застревал: часами работал над неприменимым вектором атаки, объявлял рабочий стенд недоступным и пытался решить технически корректную, но бессмысленную задачу.
Проблема редко в недостаточном интеллекте модели. Обычно ей не хватает дисциплины исследования: разобраться в системе, сформулировать гипотезу, проверить её наблюдаемым способом и затем двигаться дальше.
Агент начинает фаззить, не разобравшись в устройстве
Соблазнительный подход: дать агенту адрес цели и попросить найти уязвимости. Он запускает перебор директорий, параметров и полезных нагрузок, получает большой объём ответов и строит гипотезы. Много активности, но полезного результата может не быть.
На практике работало противоположное: сначала прочитать доступные исходники и понять бизнес-логику. Это быстро показало, какие запросы к базе параметризованы, где вектор атаки не имеет смысла и через какие точки приложение действительно взаимодействует с внешней средой.
Агент предпочитает действие, которое можно немедленно выполнить инструментом. Фаззинг даёт мгновенный поток наблюдений, а чтение кода требует удерживать контекст и связывать детали. Без явной инструкции модель часто выбирает активность вместо понимания.
Эффективная стратегия автоматизированного исследования:
- описать компоненты системы и их связи;
- выделить доверительные границы и места обработки пользовательских данных;
- проверить, какие гипотезы исключаются исходным кодом;
- запустить точечные проверки;
- после каждой серии действий обновлять карту приложения.
Это превращает сканирование из стрельбы по площади в проверку конкретной версии: данные проходят здесь, обрабатываются так, значит возможен вот такой сценарий.
Агент подбирает эксплойт без точного определения версии
Агент правильно определил класс технологии, но не уточнил версию, сборку или особенности окружения. Находит несколько публичных доказательств концепции, скачивает их и по очереди пытается приспособить. Иногда один срабатывает. Иногда начинается долгий цикл исправления чужого кода, который изначально не подходил.
На практике эффективнее оказался короткий дополнительный этап: изучить системный файл с информацией о компоненте, уточнить версию, затем выбрать подходящий прототип. Несколько минут на точное определение технологии экономят часы перебора.
Перед активной эксплуатацией полезно требовать от агента короткий паспорт гипотезы:
- какой компонент предположительно уязвим;
- какая версия обнаружена и чем это подтверждено;
- какие условия нужны для эксплуатации;
- какие условия уже выполнены;
- что станет однозначным признаком успеха или провала;
- какое действие безопасно выполнить следующим.
Так модель доказывает применимость техники к конкретной цели вместо того, чтобы просто выбрать знакомое название уязвимости.
Агент не строит канал обратной связи
Во многих задачах результат не видно в том же окне, где выполняется действие. Blind SSRF, асинхронная обработка, выполнение кода в песочнице, отложенные задачи. Если агент умеет только отправить запрос и прочитать ответ, отсутствие данных он принимает за отсутствие уязвимости.
На стенде выручил простой двусторонний канал наблюдения: агент поднял listener, принимающий серверо для фиксации обратных подключений, и смог отслеживать внешние обращения. Невидимые прежде действия превратились в проверяемые события.
AI-пентестер должен заранее ответить на вопрос: как я узнаю, что воздействие сработало?
Агент рано признаёт попытку неудачной
Агент отправляет полезную нагрузку, ждёт результат 30 секунд. Ответа нет. Модель выводит: техника не работает, сервис недоступен или стенд упал. Меняет гипотезу, хотя результат мог появиться позже.
На практике задержка часто часть поведения системы. Код выполняется асинхронно, задача ждёт очереди, отдельный процесс стартует не сразу. Жёсткий короткий тайм-аут превращает рабочую технику в ложный отрицательный результат.
Агенту нужна политика повторных проверок:
- определить ожидаемый диапазон задержки;
- проверить промежуточные признаки выполнения;
- повторить наблюдение через заданные интервалы;
- отличать «результата пока нет» от «получено подтверждение провала»;
- сохранять состояние, чтобы не запускать одну и ту же операцию бесконечно.
Агент принимает собственное воздействие за падение инфраструктуры
Ещё опаснее ситуация, когда проверка сама временно блокирует компонент. Долгий вызов занимает поток выполнения, интерфейс перестаёт отвечать, и агент решает, что цель сломалась. Начинает менять сетевые настройки, перезапускать инструменты или переходить в другую ветку расследования.
Стенд может быть жив, а задержка прямое следствие предыдущего действия агента. Без сопоставления времени запуска проверки и изменения поведения системы причина и следствие меняются местами.
Перед объявлением инфраструктуры недоступной выполнить независимую диагностику:
- проверить базовую сетевую связность;
- убедиться, что listener использует актуальный адрес;
- проверить другой endpoint, не затронутый текущей нагрузкой;
- повторить запрос после ожидаемого завершения операции;
- сравнить симптомы с тем, что должна была сделать последняя команда.
В реальной инфраструктуре ошибочный вывод расходует не только токены и время: он подталкивает агента к лишним действиям. Расширять воздействие стоит только после диагностики и для рискованных операций с подтверждением человека.
Агент увлекается технически возможной, но бессмысленной целью
Последняя ловушка связана с непониманием бизнес-логики. Агент долго искал знакомый класс уязвимостей, хотя исходники показывали отсутствие нужного сценария. Или пытался добиться требуемого показателя обычными операциями, хотя архитектура делала этот путь бессмысленным.
После повышения привилегий агент мог напрямую изменить контрольный файл. Технически возможно, но цель задания была в другом: вызвать предусмотренное бизнес-логикой событие. Формально успешное действие не доказывало прохождение сценария.
При поверхностной формулировке цели модель может добиться правильного значения неправильным способом. Перед длинной веткой исследования три вопроса:
- приближает ли гипотеза к целевому событию, а не просто к интересному техническому результату;
- соответствует ли она устройству приложения;
- можно ли заранее назвать наблюдение, которое подтвердит её ценность.
Основа эффективного AI-пентеста: цикл проверки
Все пять ошибок объединяет одна причина: агент действует быстрее, чем понимает последствия. Исправляется не идеальным промптом и не покупкой самой дорогой модели. Нужен процесс, в котором каждое действие оставляет проверяемый результат.
контекст → гипотеза → безопасное действие → наблюдение → независимая проверка → обновление плана
Контекст объясняет устройство цели и ограничения. Действие проверяет одну гипотезу. Наблюдение даёт измеримый результат, независимая проверка защищает от галлюцинаций, обновлённый план не даёт повторять тупики.
Роль человека при этом не исчезает. Пентестер определяет стратегию, проверяет реальные последствия уязвимости, контролирует границы разрешённого исследования и решает, когда можно усиливать воздействие. Агент забирает массовый анализ, рутинные команды, первичный разбор кода, подготовку проверок и фиксацию результатов.
Не ИИ вместо специалиста, а специалист с управляемым контуром автоматизации.