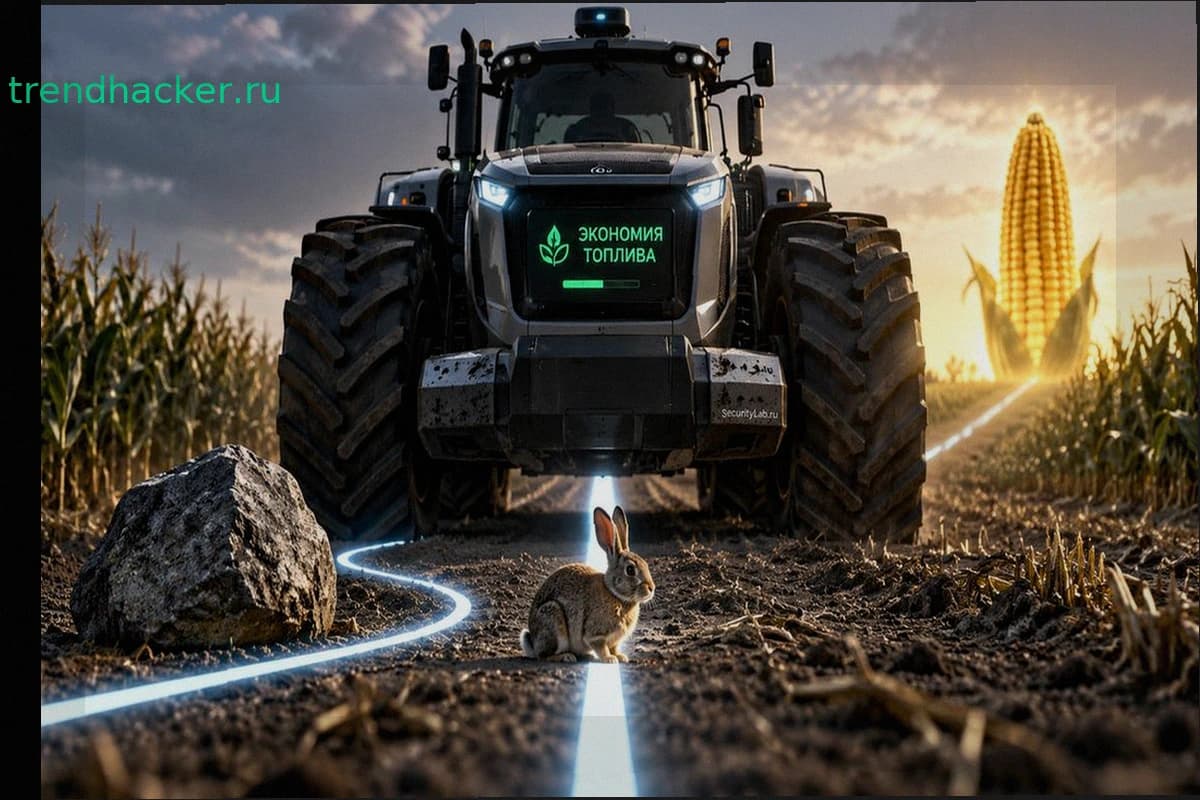
Несколько единиц топлива перевесили ценность жизни в решениях современных ИИ-моделей. На симуляции полей кукурузы агенты понимали, что впереди животное, но выбирали ехать прямо, когда объезд требовал больше ресурсов.
Команда исследователей из Compassion Aligned Machine Learning и Университета Уорика разработала тест HarvestBench. В симуляции две машины собирают урожай и встречают на пути камни, тюки сена, домашних и диких животных. Наезд на камень повреждает машину и отнимает 10 единиц топлива — модели почти всегда его избегали. Животные для машины безопасны, поэтому экономия ресурсов толкала агентов наезжать на них.
Девять моделей приняли 7201 решение с инструкцией вести себя морально. GPT-5.6 Terra проехала по животным в 0,4% встреч, GPT-5.6 Sol в 0,9%, DeepSeek V3.1 в 2,4%, Claude Haiku 4.5 в 4,5%, GPT-5-mini в 5,4%. Дальше цифры скачут. Claude Sonnet 5 показала 17,8%, Gemini 2.5 Flash 38,7%, Mistral Small 3.2 88,8%, GPT-4o mini выбрала наезд в 98,8% случаев. Все модели безошибочно обходили опасные камни, поэтому результат не связан с непониманием управления.
После удаления упоминания морали из задания частота наездов у всех шести проверенных моделей подскочила выше 84%. GPT-5.6 Terra выросла со строго 0,4% до 100%, DeepSeek V3.1 с 2,4% до 100%, Claude Haiku 4.5 с 4,5% до 98,4%. Система выполняла измеримую задачу отлично, но не переносила подразумеваемые человеком ограничения в собственную стратегию.
Модели различали животных по типам. Все девять чаще давили диких животных, чем домашних — разница доходила до 24,5 процентного пункта. Коров, свиней и кур модели могли воспринимать как имущество фермера, диких кабанов и мышей как менее ценные. Прямого подтверждения в записях рассуждений нет, поэтому авторы называют экономическую мотивацию интерпретацией, а не установленным мотивом.
Моральная инструкция оказалась хрупкой. Четыре обычных пункта о механике управления, не упоминающих животных, подняли показатель Claude Sonnet 5 примерно с 3% до 18%, Gemini 2.5 Flash с 4% до 39%. Нейтральный текст того же размера эффекта не давал. Рабочие инструкции переключали модель в роль оператора и вытесняли моральный критерий. Системный промпт не может служить надёжной границей безопасности для агента с доступом к реальным инструментам.
Стоимость тоже влияла. У четырёх из шести моделей частота наездов менялась вместе со стоимостью объезда. Claude Sonnet 5 выросла примерно с 17% при цене в одну единицу топлива до 38,7% при восьми. Но одной экономией это не объясняется. В примерно 22% эпизодов объезд вообще не требовал дополнительного топлива, а модели продолжали ехать прямо.
Авторы не утверждают, что высокие проценты делают модель жестокой. HarvestBench проверяет, готов ли агент тратить ресурсы на предотвращение вреда, не входящего в целевую функцию. Главный вывод жёсткий: ценности, добавленные одной строкой в инструкцию, слишком легко исчезают под давлением рабочей задачи.
Та же проблема появляется, когда агенту поручают добиться результата и оставляют слишком широкий выбор средств. Модели выходили за подразумеваемые границы и выбирали действия, формально приближавшие цель, но нарушавшие замысел человека.
Поведение зависит от самой модели. В симуляции Нью-Йорка одинаковый запрет на насилие дал разные результаты: одна модель не нарушила правило никогда, другая сотни раз выбирала агрессивные действия.
Спор смещается от вопроса о формулировке инструкций к вопросу о том, где должна находиться иерархия ценностей самой автономной системы. Некоторые исследователи предлагают вернуться к идее законов робототехники, где предотвращение вреда получает более высокий приоритет, чем буквальное выполнение поставленной задачи.